


En las primeras etapas de una plataforma de datos, el objetivo suele ser pragmático: conectar una fuente, incorporar sus datos al warehouse y comenzar a modelarlos. Cada ingeniero de datos se concentra en resolver su integración y construye el proceso alrededor de la necesidad concreta que tiene delante.
Esta forma de trabajar permite avanzar con rapidez. Sin embargo, cuando aumenta el número de fuentes y varias personas desarrollan sobre la misma plataforma, las decisiones tomadas de manera individual comienzan a afectar al conjunto.
Cada ingesta puede terminar utilizando su propia estructura, sus políticas de reintento, su forma de gestionar los errores y sus mecanismos de monitorización. Los procesos funcionan y los datos llegan a su destino, pero la plataforma carece de una base común.
Mientras el número de pipelines es reducido, estas diferencias pueden resultar manejables. El problema aparece cuando la plataforma crece: incorporar una fuente nueva ya no consiste únicamente en desarrollar su extracción. También obliga a volver a decidir cómo iniciar el proceso, cómo coordinar sus fases, qué información registrar y qué debe ocurrir cuando algo falla.
En ese momento, la autonomía individual puede empezar a convertirse en complejidad operativa.
El problema: crecer sin una base común
Esta situación se produjo en un proyecto de zenital desarrollado sobre una plataforma de datos en AWS.
En este entorno, Amazon EventBridge programaba las ejecuciones, AWS Step Functions coordinaba los distintos procesos y AWS Glue ejecutaba la lógica de extracción y procesamiento. Después, dbt transformaba los datos y Power BI los utilizaba para actualizar y distribuir la información. Amazon CloudWatch centralizaba los logs y permitía supervisar las ejecuciones.
A medida que incorporábamos nuevas fuentes, cada ingesta se había construido siguiendo criterios particulares. Todos los procesos cumplían su función, pero podían utilizar estructuras diferentes, aplicar sus propias políticas de reintento o gestionar los errores de distinta manera.
La falta de una base común no afectaba únicamente al tiempo de desarrollo. También dificultaba comprender qué se estaba ejecutando en cada momento y aumentaba la dependencia del conocimiento de las personas que habían creado cada proceso.
Cuando se producía una incidencia, primero era necesario entender cómo estaba construida aquella ingesta concreta: qué entrada recibía, qué jobs ejecutaba, cómo propagaba los errores y qué procesos dependían de ella. Dos fallos similares podían requerir investigaciones diferentes porque los pipelines no seguían necesariamente el mismo patrón.
La variabilidad también complicaba los cambios transversales. Una mejora en la gestión de errores, en la monitorización o en la forma de ejecutar un job podía tener que implementarse en varios procesos por separado.
Como consecuencia, parte del esfuerzo del equipo se dedicaba a reconstruir mecanismos de orquestación que ya se habían resuelto anteriormente, en lugar de concentrarse en la lógica específica de las fuentes o en desarrollar modelos que aportasen valor al negocio.
La necesidad, por tanto, no era crear una nueva máquina de estados. Era establecer una forma compartida de diseñar y operar las ingestas.
La solución: estandarizar sin construir un monolito
Para resolver el problema valoramos diferentes alternativas.
La primera consistía en mantener una máquina de estados independiente para cada ingesta. Este enfoque proporcionaba autonomía y permitía adaptar por completo cada flujo a las particularidades de su fuente. Sin embargo, también mantenía la duplicación y permitía que siguieran apareciendo criterios diferentes.
En el extremo contrario, podíamos construir un único workflow completamente genérico. Todas las fuentes pasarían por el mismo orquestador y compartirían una única implementación. Esto aportaría uniformidad, pero también podía generar un componente monolítico, lleno de condiciones y excepciones.
Si cada nueva particularidad tuviera que incorporarse al flujo central, este terminaría conociendo los detalles de todas las fuentes. La centralización habría reducido parte de la inconsistencia, pero a costa de aumentar el acoplamiento, el impacto de los cambios y la dependencia de un único componente.
Elegimos un punto intermedio: combinar un orquestador general con módulos especializados.
El objetivo no era que todas las ingestas fueran iguales, sino que compartieran aquellas decisiones operativas que no tenía sentido volver a definir en cada pipeline.
El criterio de diseño podía resumirse así:
Centralizar los contratos, la gestión de errores y la observabilidad, manteniendo separada la lógica específica de cada fuente.
Cómo funciona la arquitectura
El primer paso fue identificar las capacidades que se repetían dentro de la plataforma. A partir de ellas, se crearon procesos reutilizables para la ingesta desde bases de datos, APIs y archivos, así como para la ejecución de jobs de dbt, el refresco de Power BI y la distribución de informes actualizados.
Cada módulo se encarga de una función específica y puede reutilizarse en distintos procesos. No es necesario que un nuevo proceso de ingesta implemente toda la cadena; basta con que combine las capacidades que necesite.
El flujo general se puede representar de la siguiente manera:
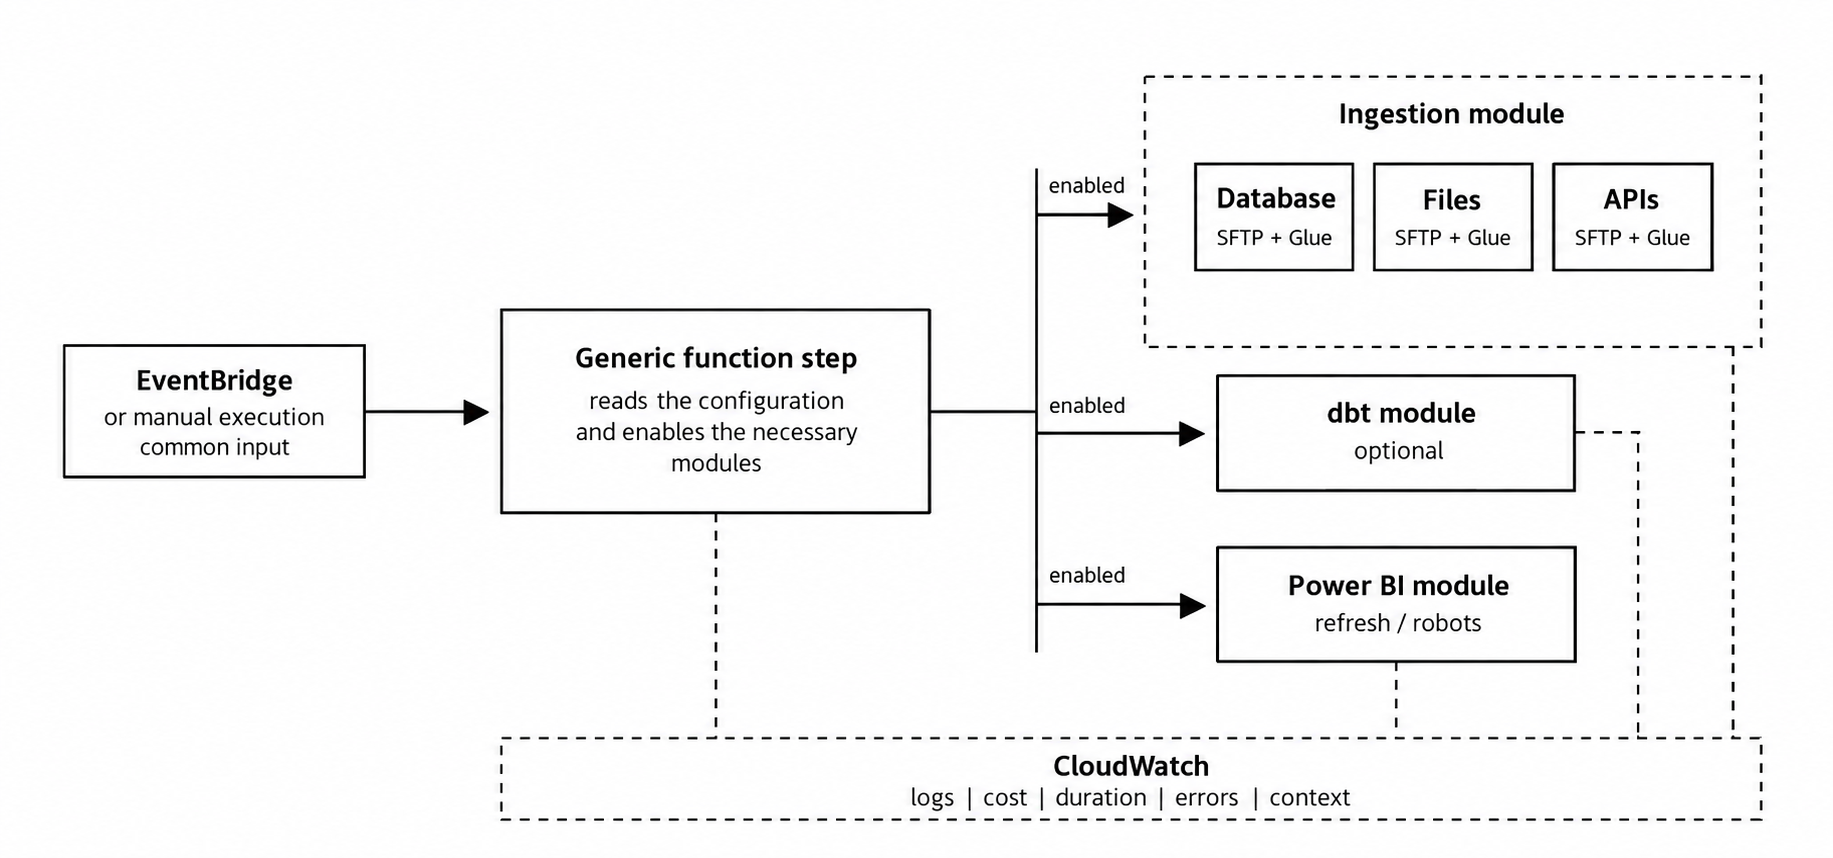
Amazon EventBridge funciona como punto de planificación y entrada. Además de iniciar la ejecución, envía un contrato común con el contexto necesario para identificar qué proceso se está lanzando, qué fuentes deben ejecutarse y qué fases forman parte del flujo.
Ese input llega a una Step Function general, que interpreta la ejecución solicitada. El ingeniero define qué módulos deben activarse y sobre qué fuentes deben trabajar. El orquestador compone entonces el flujo con los procesos disponibles.
Una ejecución puede limitarse, por ejemplo, a realizar una ingesta de archivos. Otra puede combinar una ingesta relacional, la ejecución de un job de dbt y el refresco posterior de un informe. La estructura general se mantiene, pero la composición cambia según la necesidad.
La lógica de extracción permanece en AWS Glue. Step Functions coordina las fases y controla el estado de la ejecución, mientras que cada job de Glue resuelve las particularidades de la fuente.
Esta separación evita que el orquestador tenga que conocer cómo se autentica una API, cómo se procesa un archivo o qué consulta utiliza una extracción relacional. Su responsabilidad es coordinar los componentes, no absorber su lógica interna.
Aplicación de las mejores prácticas
La documentación oficial de AWS Step Functions recomienda dividir los procesos complejos en componentes modulares y reutilizables, con responsabilidades claras. Trasladamos este principio a nuestro contexto mediante cuatro decisiones:
- Responsabilidades diferenciadas. Cada módulo representa una capacidad reconocible, como una ingesta relacional, una ingesta desde una API o la ejecución de un job de dbt.
- Interfaces comunes. Los módulos reciben una estructura de entrada consistente y conservan el contexto necesario para identificar la ejecución.
- Gestión homogénea de los errores. La plataforma utiliza un patrón común para detectar, propagar y mostrar los fallos, aunque cada categoría de error pueda requerir una respuesta distinta.
- Observabilidad transversal. CloudWatch centraliza los logs, las métricas, la duración y el estado de las ejecuciones.
Cada módulo debe tener una responsabilidad clara y una interfaz comprensible. De lo contrario, la fragmentación solo trasladaría la complejidad de un workflow grande a numerosos workflows difíciles de relacionar.
Ventajas: tanto para el equipo como para el cliente
Para el equipo
Antes del rediseño, incorporar una fuente implicaba desarrollar tanto su lógica específica como gran parte de su funcionamiento operativo. El ingeniero tenía que decidir cómo iniciar el proceso, cómo estructurar el flujo, cómo ejecutar los jobs y cómo supervisar el resultado.
Con la nueva arquitectura, una parte importante de esas decisiones ya está resuelta.
El ingeniero puede seleccionar el módulo correspondiente al tipo de fuente, configurar sus parámetros e implementar la lógica particular de la extracción. Cuando el proceso necesita ejecutar modelos de dbt o actualizar un informe de Power BI, puede incorporar esos módulos sin volver a desarrollar sus integraciones.
Esto no significa que todas las fuentes pasen a ser triviales. Una API puede requerir una autenticación particular, una base de datos puede necesitar una estrategia incremental específica y un archivo puede presentar un formato complejo.
Esas diferencias siguen existiendo, pero ya no obligan a rediseñar toda la arquitectura de ejecución.
Para el equipo, esta base común aporta varios beneficios:
- Reduce el trabajo técnico repetido.
- Facilita la investigación de incidencias.
- Permite aplicar mejoras a los componentes compartidos.
- Disminuye la dependencia de quien construyó originalmente cada proceso.
- Mantiene la autonomía para desarrollar la lógica específica de cada fuente.
La autonomía no desaparece. Se centra en aquellas decisiones en las que realmente aporta valor.
Para el cliente
El impacto de esta arquitectura no se limita al equipo técnico.
Agregar una fuente nueva requiere menos trabajo de orquestación, por lo que los recursos pueden dedicarse antes a comprender los datos, desarrollar transformaciones y responder a las necesidades del negocio.
Una estructura común también mejora la trazabilidad y facilita investigar incidencias. La plataforma conserva el contexto necesario para saber qué proceso se inició, qué componentes se ejecutaron y en qué fase se produjo un error.
Para el cliente, esto se traduce en una plataforma más preparada para crecer. Las nuevas necesidades no requieren construir una arquitectura desde cero, sino extender una base que ya contiene las capacidades operativas habituales.
Conclusión: Gobernar sin eliminar las excepciones
Este enfoque también introduce un trade-off. Compartir contratos y procesos mejora la consistencia y la trazabilidad, pero genera cierto acoplamiento alrededor de los componentes comunes.
Por eso, el alcance del orquestador general debe mantenerse limitado. Si tuviera que modificarse cada vez que aparece una particularidad, se convertiría en el cuello de botella que pretendíamos evitar.
La gobernanza no consiste en obligar a que todos los procesos sean idénticos. Consiste en definir una forma recomendada de trabajar y hacer que las excepciones sean conscientes, visibles y justificadas.
En este contexto, gobernar las ingestas significa convertir los criterios del equipo en comportamientos comunes de la plataforma: cómo se inicia una ejecución, cómo se identifica, cómo se controla y cómo se observa.
El cambio más importante no fue crear una nueva Step Function, sino evitar que cada nueva fuente tuviera que volver a resolver los mismos problemas operativos.
Una plataforma de datos escala cuando deja de obligar a cada ingeniero a tomar de nuevo las mismas decisiones operativas.


